
再生塑料里的"隐形污染物", 凭什么敢写进报告?
陶氏化学核心研发部分析科学团队在 ACS Measurement Science Au发表了 Lin、Yang 等人的工作:An Advanced GC−MS Workflow for High-Confidence Non-Targeted Screening of Non-Intentionally Added Substances in Recycled Plastics(开放获取)。
做过再生料检测的人都知道这条路上的"坑":一个再生 HDPE 样品,溶剂一萃、进样一针,出来几百个峰。NIST 库打一遍,有把握的没几个,模棱两可的一大片。报告怎么写?"疑似"写多了客户不认,"确认"写多了自己心虚。
卡点不是分离不出峰,而是缺少一个"凭什么下结论"的规则。
这篇文章的价值不在某一台仪器,而在一条完整的思路。本文按"问题 → 思路 → 实现 → 验证"把它拆开讲,最后说清楚文章里 GC/ID 扮演的角色。
一、问题:再生塑料筛查卡在哪里
循环经济下再生塑料(PCR)用量猛增——但 2019 年全球塑料废弃物只有 14–18% 被真正回收。回收率上不去的核心障碍之一是质量,而再生料的质量几乎完全取决于 NIAS——非有意添加物质(Non-Intentionally Added Substances):
| 来源 | 典型代表 |
| 残留助剂 | 抗氧剂、爽滑剂、增塑剂 |
| 降解产物 | 聚合物断链产生的低聚物 |
| 反应中间体 | 合成过程的副产物 |
| 回收环境带入 | 矿物油、消费者残留、清洗残留 |
分子量 < 500 Da 的小分子 NIAS 尤其值得警惕——有内在危害性,又容易迁移,对食品接触材料尤其敏感。
麻烦在于再生料的来源是一条"混合流",一个样品能有几百种可检出的化学物种。传统 1D GC/MS 的真实处境:
共流出严重
——几百个峰挤在一维色谱上,匹配分数被硬生生压低;
基线被抬起
——文章用一张 TIC 图摆上台面:20–26 min 段渗出的低聚物和矿物油污染把基线抬得老高,谱库匹配雪上加霜;
结果没法报
——NIST 给一堆名字,"疑似"和"确认"之间没有规则可依。
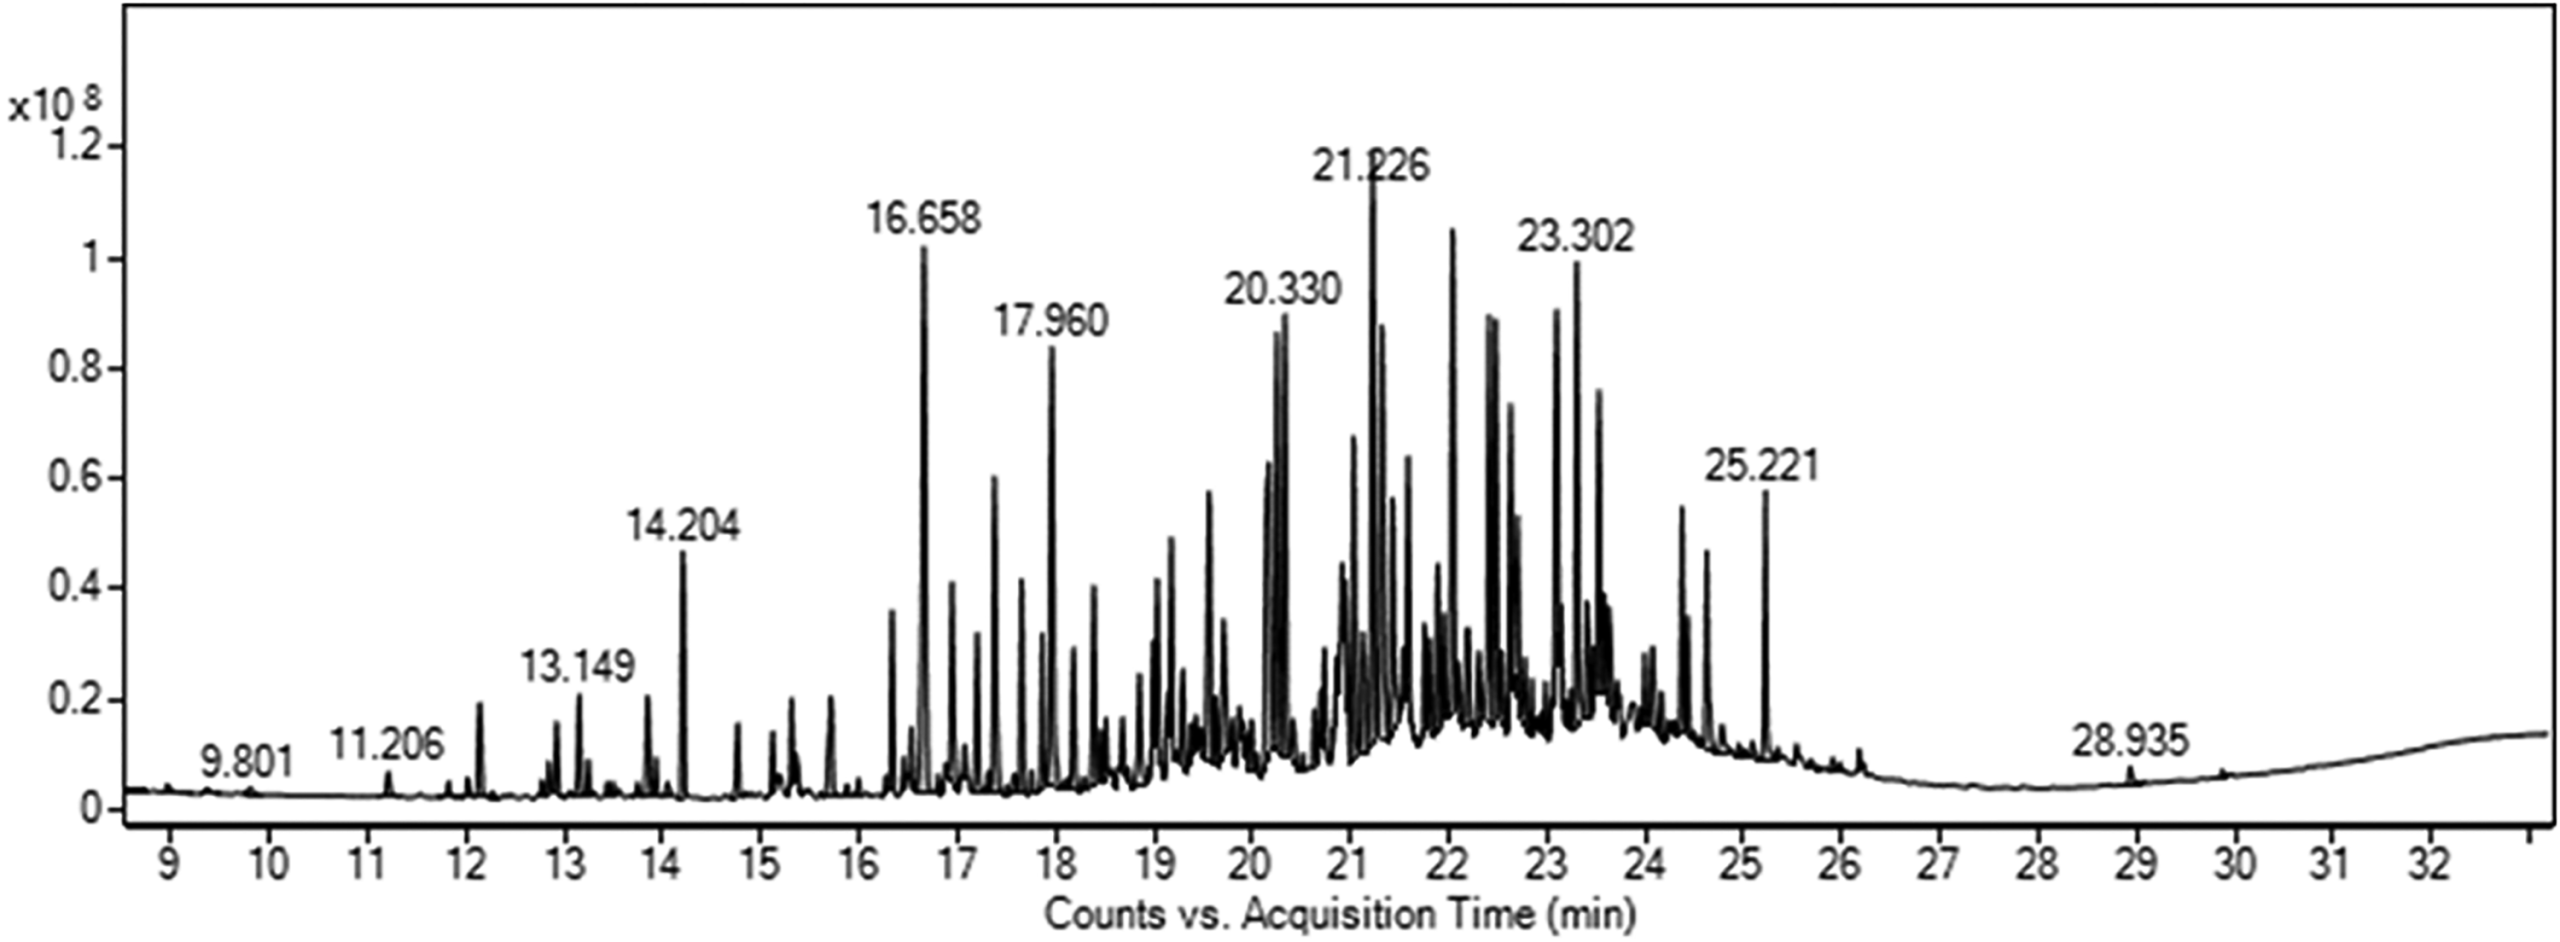
再生 HDPE 萃取液的 1D GC/MS TIC 图(原文 Figure 2)。20–26 min 区间大量峰共流出,基线被渗出的低聚物和矿物油持续抬高——传统一维分离的真实处境。
二、思路:把"置信度"变成可执行的标准
作者的破题思路是三步:
第一步,把复杂度降下来——用 GC×GC 把共流出拆开。选的是 Agilent 反流差分流量调制器,无冷媒,装在同一柱温箱里,保留时间重复性和峰形都做得很漂亮。
第二步,把证据维度补齐——用 q-TOF 提供精确质量(每天校准,质量准确度<2.0 ppm,EI 70 eV,50 Hz,m/z 40–500),同时 FID 双通道采集做二维色图对照。作者也很坦诚地写了双检测器的差异:q-TOF 侧斑块更宽、强度更低,原因是流量低 10 倍、传输毛细管扩散、线性动态范围更窄、高沸点分子电离效率低。这种诚实反而让人更信任这套流程。
第三步,也是最核心的一步:定义"置信度"的判据。 不依赖单一指标,而是设计三个独立的证据描述符:
| 描述符 | 判据 |
| A | NIST 谱图匹配:DMF 且 RMF > 700 |
| B | 一维保留指数误差 1LRI < 20 |
| C | 精确质量误差 < 10 ppm(分子离子或主要碎片) |
三者组合推出 4 个置信度等级、7 种分类,每个鉴定结果必须"对号入座":
高置信度 ── A + B + C 全通过 中置信度 ── A+B(缺精确质量)/ A+C(缺保留指数) 低置信度 ── A 单独通过 / B+C / 其他组合 无置信度 ── 无描述符通过
这个排序本身就有观点:谱图匹配和保留指数排在 HRMS 之上。理由是 HRMS 只能给出元素组成,没有碎片指纹定不了结构——没有把"高分辨"神化。
配套还有几条严谨的规则:
NIST 库无 RI 参考的化合物,一律算未通过描述符 B
,不管谱图匹配多好;
A+B 和 A+C 必须与 B+C 分开统计
——单独 HRMS 或单独 ¹LRI 都不足以定结构;
柱流失导致噪声上升时,DMF 会明显下降,但 RMF 仍能维持较高——因为 RMF 只单向检查库谱峰是否出现在实验谱中。这条经验对老化柱子、高沸点区化合物的分析非常实用。
一句话总结这个思路:把分析化学从"匹配分数游戏"变成"证据链工程"。
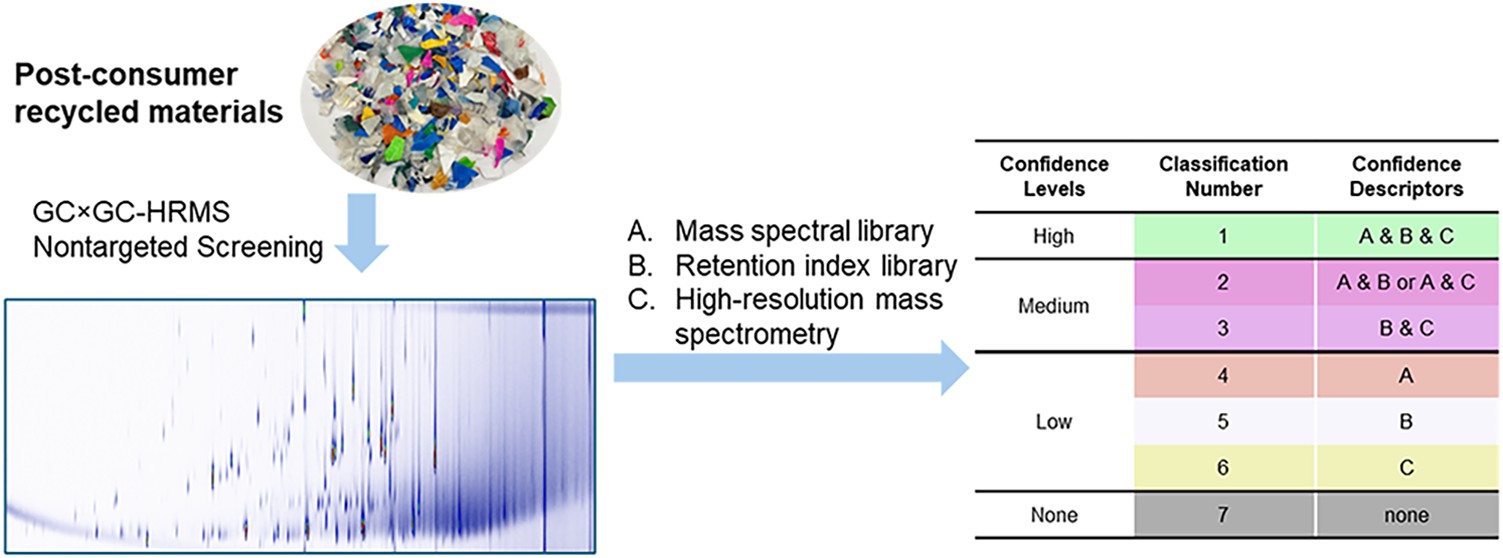
整套工作流与置信度框架总览(原文 Graphical Abstract)。再生料经 GC×GC 非靶向筛查后,A(谱图库)、B(保留指数库)、C(高分辨质谱)三类证据组合映射为 4 个置信度等级。
三、实现:从方法到批量处理
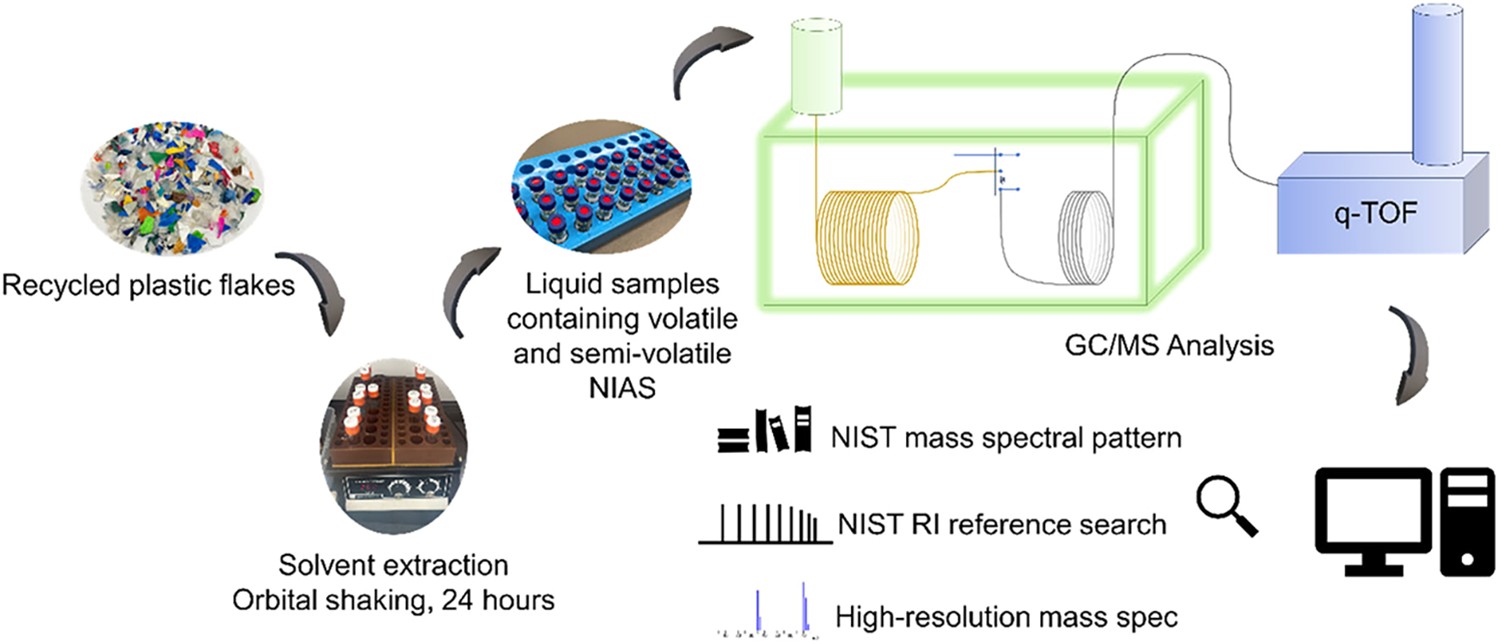
完整实验流程(原文 Figure 1)。塑料片料经溶剂萃取(轨道振荡 24 h)后进入 GC×GC/q-TOF 分析,NIST 质谱图、RI 参考、高分辨质谱三路比对。
柱系统选择:对比三套组合——VF-200 ms × VF-1 ms(无 RI 库可引用)、DB-5 ms UI × DB-HeavyWAX(约 150 个化合物)、DB-1 ms UI × DB-HeavyWAX(约 160 个,最优)。最终选组合 3 的关键理由:只有标准非极性(100% 二甲基聚硅氧烷)和半标准非极性(5% 苯基)两种固定相,NIST 库里有可直接引用的保留指数参考,描述符 B 才有依据。作者还解释了为什么选 DB-1 而不是 DB-5:苯基是挂在骨架里还是侧链上,芳香类化合物的 RI 误差就不一样;加上柱老化会让固定相偏离原始组成——RI 要现标(C7–C30 正构烷烃),才能变成"可用证据"。
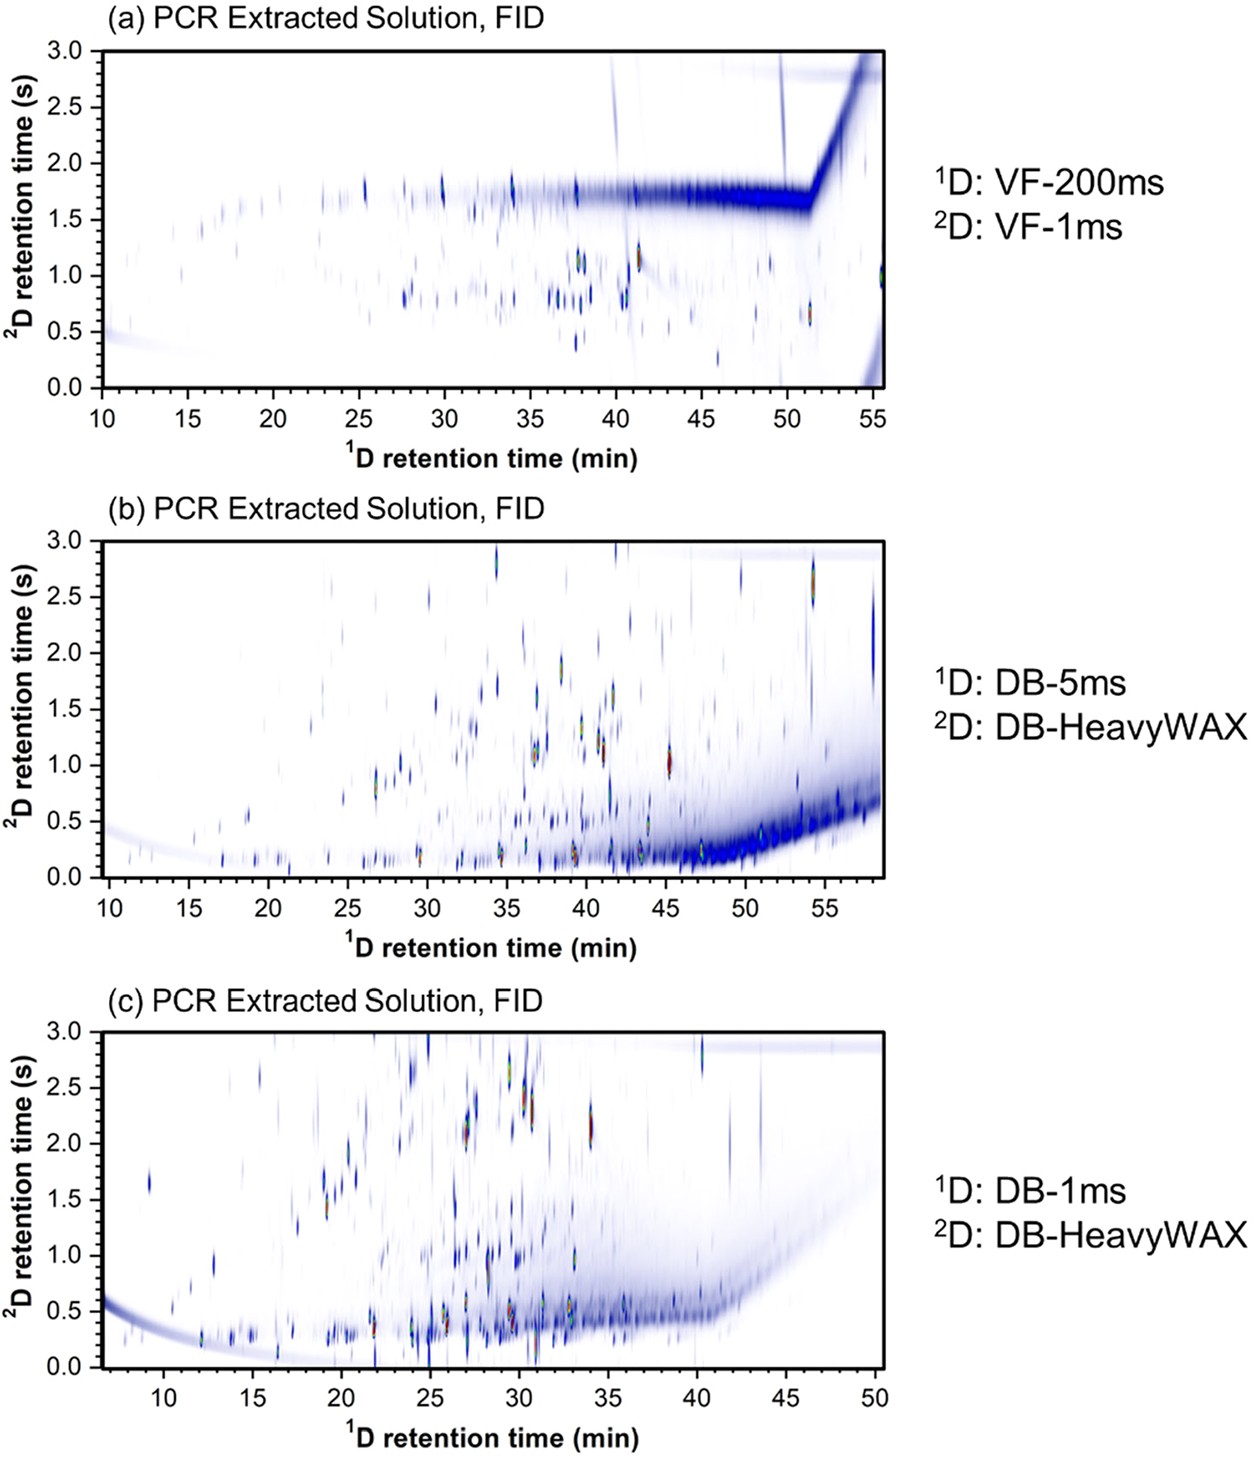
三套柱系统的二维色图对比(原文 Figure 3)。(c) DB-1 ms × DB-HeavyWAX 组合分离效果最优,且其固定相在 NIST 库中有可引用的保留指数参考。
优化后的方法参数
一维 20 m × 180 μm × 0.18 μm DB-1 ms UI;二维 5 m × 250 μm × 0.20 μm DB-HeavyWAX;40 °C(1 min)→ 6 °C/min → 280 °C(20 min);二维采样窗口 4.5–43 min;He 载气,一维 0.6 mL/min(43 min 后反吹),二维 20 mL/min;二维流出 9:1 分流至 FID 与 q-TOF。
样品与模板:回收厂清洗前后 HDPE 片料,二氯甲烷 1:4 萃取 24 h(5 g 样品 / 20 g 溶剂),0.45 μm 过滤。用清洗前样品的二维色图建"特征模板"(体积阈值 10⁶,像素容差 4 px),再批量套用到所有样品——让"几百峰 × 多样品"从不可能变成可行。
验证设计:三组标样——NIAS 混标(萘、4-戊基酚、4-氯联苯、二苯甲酮、DBP、双酚 A)、EPA 506 增塑剂 7 种、PAH 混标 13 种——分别以 5 ppm 和 1 ppm 加标到再生料基质。用"已知答案的考试"检验框架的假阳性和假阴性。
四、结果:思路跑通的证据
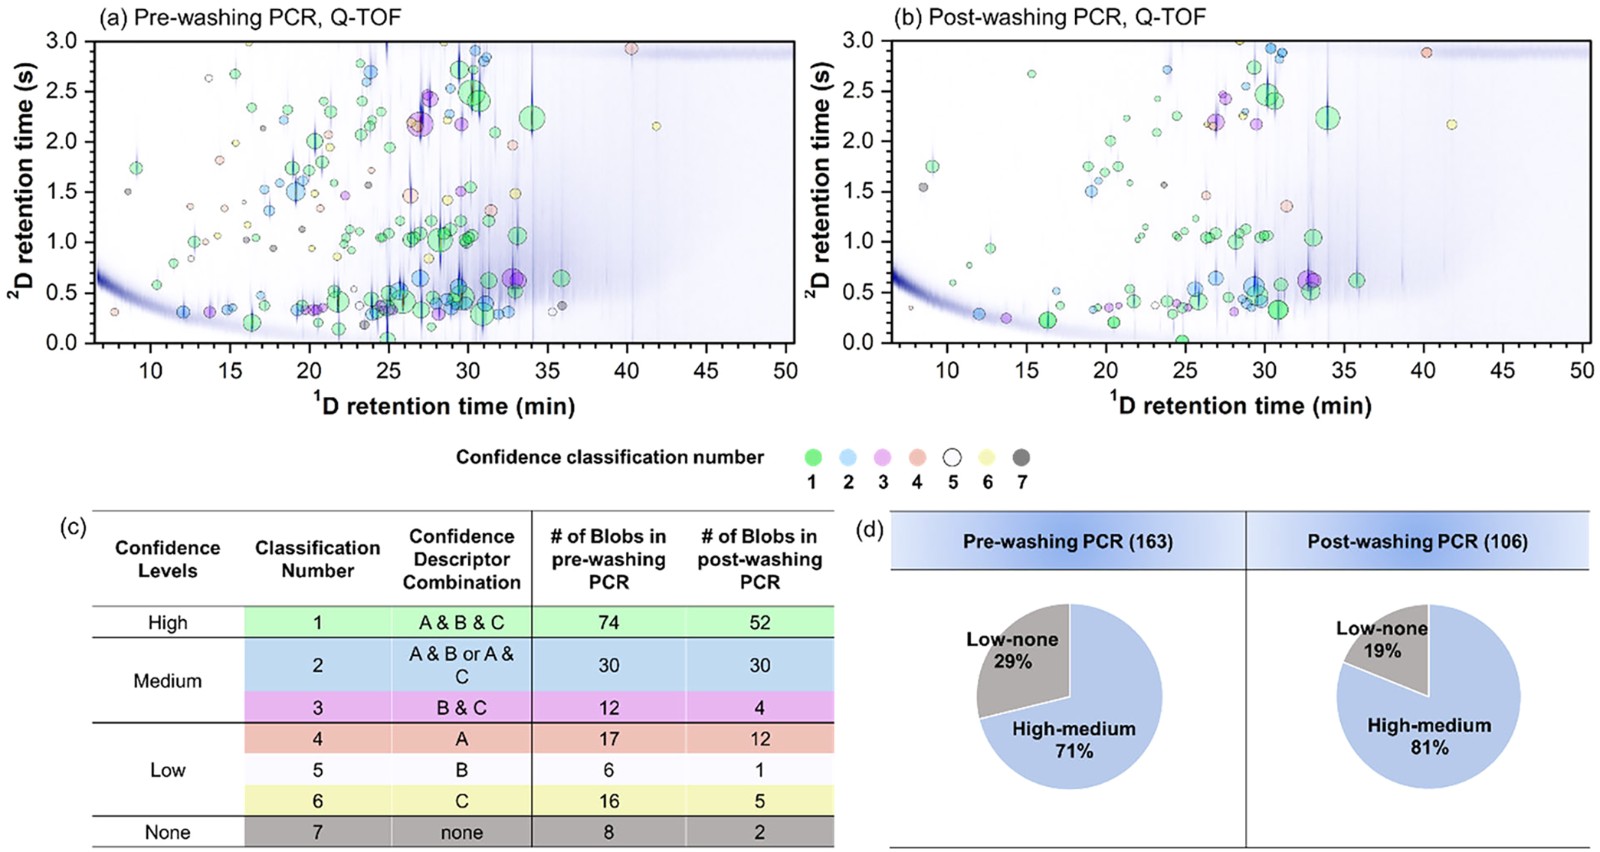
清洗前样品 163 个斑块,71% 达中高置信度;清洗后升至 81%——框架不仅识别污染物,还能量化评价清洗工艺的效果;
与 1D GC/MS 相比,分离鉴定峰数从约 80–100 提升到约 150(约 50%),采集时间仅从 42 min 增至 53 min——50% 提升,几乎零时间代价;
重复进样 5 次,一维/二维保留时间 RSD 很低,斑块体积最大变异仅 7.2%;

清洗前后样品的置信度结果(原文 Figure 5)。色图上每个圆斑即一个检出化合物,颜色对应置信度分类;(d) 饼图显示中高置信度占比从清洗前 71% 升至清洗后 81%。
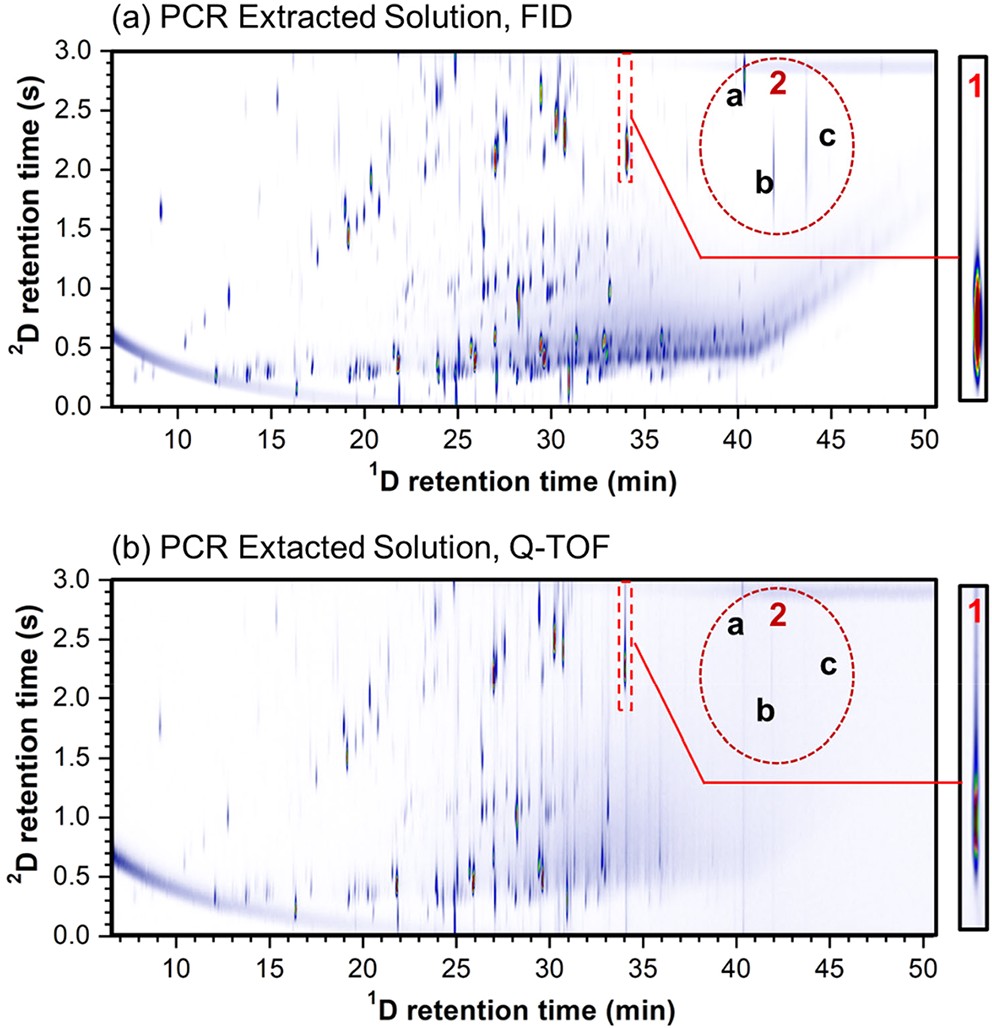
FID(上)与 q-TOF(下)对同一 PCR 样品的二维色图对比(原文 Figure 4)。q-TOF 侧斑块更宽、强度更低——流量低 10 倍、接口扩散、动态范围更窄所致,作者如实写明了差异。
加标实验也如实暴露了边界:4-戊基酚 RI 偏 −46(超惰性柱表面硅醇基少,极性分析物 RI 会偏移);1 ppm 下 BBP、DNOP、苯并[a]蒽、䓛、苯并[k]荧蒽未检出(电离效率低);苯并[a]芘、双酚 A 在两个水平都未检出(WAX 柱温度上限 / GC 上响应低);晚流出化合物匹配因子明显低于早流出——基质干扰叠加高温柱流失。作者连"没做到"都写清楚了。
加标验证结果表(原文 Table 4)。26 个环境相关化合物以 5 ppm(左)和 1 ppm(右)加标,逐个列出保留时间、¹LRI 误差、匹配因子、质量误差与置信度分类。
还有一个很实用的结论:再生料里低聚物和油污染水平很高,强溶剂一萃全出来了,GC×GC 也分不干净(基线持续抬升)。这不是方法没做好,是基质本身的极限——作者把它当作"需要继续发展工具"的理由,而不是藏起来。
五、同一条证据链,两种落地方式
读这篇文章时值得注意:作者实际并行跑了两条数据处理路线,共享同一套置信度框架,但覆盖的证据维度不同。
路线一:1D GC/MS + GC/ID —— 普及型平台
一维分离、单四极杆采集,数据处理使用 Cerno Bioscience 的 MassWorks GC/ID 软件。GC/ID 在这条路线里承担的是:
谱图匹配
基于 NIST 库计算 DMF / RMF,落地描述符 A;
保留指数
计算并比对 ¹LRI,落地描述符 B;
批量筛查与置信度分级
对几十上百个化合物自动套用判据,输出分级结论,决定哪些直接报、哪些补标样确认。
这条路线覆盖证据链中的 A + B 两环。受限于单四极杆,给不出<10 ppm 的质量误差(描述符 C 做不了),所以加标实验里它的天花板是"中置信度"。但它胜在门槛低、通量高:绝大多数实验室手上就是那台单四极杆 GC/MS,用 GC/ID 就能把"谱图 + 保留指数"两条证据同时算清楚、按置信度分级报出来。
路线二:GC×GC/q-TOF + GC Image —— 高配型平台
无冷媒二维分离拆开共流出,q-TOF 补上精确质量这一环,数据处理使用 GC Image 完成二维色图解析与特征模板批量比对。这条路线 A + B + C 三环全占,能把置信度推到"高",实测鉴定峰数比一维多出约 50%,代价是仪器配置更高、二维方法开发更重。
两条路线对照
| 路线一:1D GC/MS + GC/ID | 路线二:GC×GC/q-TOF + GC Image | |
| 证据描述符 | A + B | A + B + C |
| 置信度天花板 | 中 | 高 |
| 相对鉴定峰数 | 基线(约 80–100) | +50%(约 150) |
| 仪器门槛 | 单四极杆 GC/MS,普及 | q-TOF + 二维调制器,较高 |
| 数据处理 | MassWorks GC/ID | GC Image |
两条路线不是替代关系,而是同一套方法论的两种配置:预算和样品量允许,上路线二拿最高置信度;日常筛查和大量常规样品,路线一 + GC/ID 就能把"敢不敢报"的问题解决掉大半。这也正是这套框架的价值——它是开放的判据体系,不绑定哪条路线、哪家软件。
六、结语
回到开头的问题:再生塑料里几百个峰,凭什么敢写进报告?
这篇文章给出的答案是:凭证据链,不凭单一分数。 谱图匹配、保留指数、精确质量——描述符各有各的判据,结果按等级对号入座,报告里每一行都有出处。3 个描述符、4 个等级、7 种分类,框架是开放的,不绑定任何一家仪器或软件。
它同时说明了一件事:这套方法论不要求你先换设备。手里是单四极杆 GC/MS 的实验室,用 GC/ID 把 A、B 两环做扎实,就已经能从"匹配分数游戏"进入"证据链工程";等需要更高的置信度和通量,再向 GC×GC/q-TOF 演进,判据体系原封不动地延续。
非靶向筛查的竞争力,正从"能分离多少峰",转向"能对多少个峰负责任地下结论"——而这个转向,从你现有的那台 GC/MS 上就可以开始。
关于绿绵科技
北京绿绵科技有限公司(简称:绿绵科技)以体现客户服务价值为宗旨,以专业精神和技能为广大实验室分析工作者提供样品前处理、样品制备及分析、实验数据精确分析和管理的全面解决方案,致力于协助客户提高分析检测的效率和水平。主要代理产品联系电话:010-82676061/2/3/4/5/6/7/8
E-mail:info@lumtech.com.cn。


